
فاتورة واجهة برمجة التطبيقات (API) الشهر الماضي جعلتني أوقف مشروع تحليل الفيديوهات الخاص بي بالكامل؛ فالتعامل مع مقاطع تمتد لساعات كان يلتهم ملايين التوكنز في ثوانٍ.
لكن إعلان جوجل (Google) الأخير قلب الموازين تماماً. لطالما كان استخراج البيانات من الفيديوهات الطويلة كابوساً مكلفاً للمطورين، حيث تقوم النماذج التقليدية بسحب إطارات ثابتة بشكل أعمى. اليوم، مع إطلاق تقنية agentic video understanding with Gemini، نحن أمام نموذج يتصرف كـ "مخرج سينمائي" ذكي؛ يقرر متى يسرع الفيديو، ومتى يدقق في إطار واحد، ومتى يعتمد على الصوت فقط، والنتيجة؟ انهيار في التكاليف مع دقة لم نعهدها من قبل.

|
| تقنية الفهم الوكيلي للفيديو تتيح لنماذج جيميني تحليل الوسائط بذكاء يوفر التكاليف ويرفع الدقة |
أعلنت شركة جوجل (Google) رسمياً عن دمج قدرات الفهم الوكيلي (Agentic Understanding) عبر أحدث نماذجها، وتحديداً عائلة فلاش التي تشمل: جيميني 3.7 فلاش (Gemini 3.7 Flash)، و 3.6 فلاش، و 3.5 فلاش-لايت. هذه الميزة متاحة الآن عبر واجهة برمجة التطبيقات (API) في (Google AI Studio) ومنصة (Gemini Enterprise Agent).
ملخص سريع (TL;DR):
- انخفاض التكاليف: تقليص استهلاك التوكنز بنسبة تصل إلى 88%، مما يخفض التكلفة المادية بنحو 66%.
- دقة أعلى: زيادة في دقة التحليل بنسبة 7% بفضل المعالجة الديناميكية للإطارات والصوت.
- تحليل ذكي للإطارات (FPS): يتخلى النموذج عن السحب الثابت للإطارات، ويقرر سرعة القراءة ومناطق التركيز بنفسه.
- سهولة الدمج: سطر برمجي واحد
"processing": "agentic"يكفي لتفعيل هذه القوة الجبارة.
محتويات المقال:
ما الذي تغيّر؟ من التحليل الأعمى إلى "الوكيل" الذكي
لم أستوعب في البداية معنى كلمة "وكيلي" (Agentic) في سياق الفيديو، حتى راقبت كيف يتعامل النموذج مع مقطع مدته 40 دقيقة؛ لقد قفز مباشرة إلى الدقيقة 15 وتجاهل الباقي لأنه وجد ما يبحث عنه في النص الصوتي المفرغ! تاريخياً، عندما كنا نغذي نماذج اللغات الكبيرة (LLMs) بفيديو، كانت تعمل بطريقة "المعالجة الثابتة" (Static Processing). هذا يعني سحب إطار واحد كل ثانية (1 FPS) بغض النظر عن المحتوى.
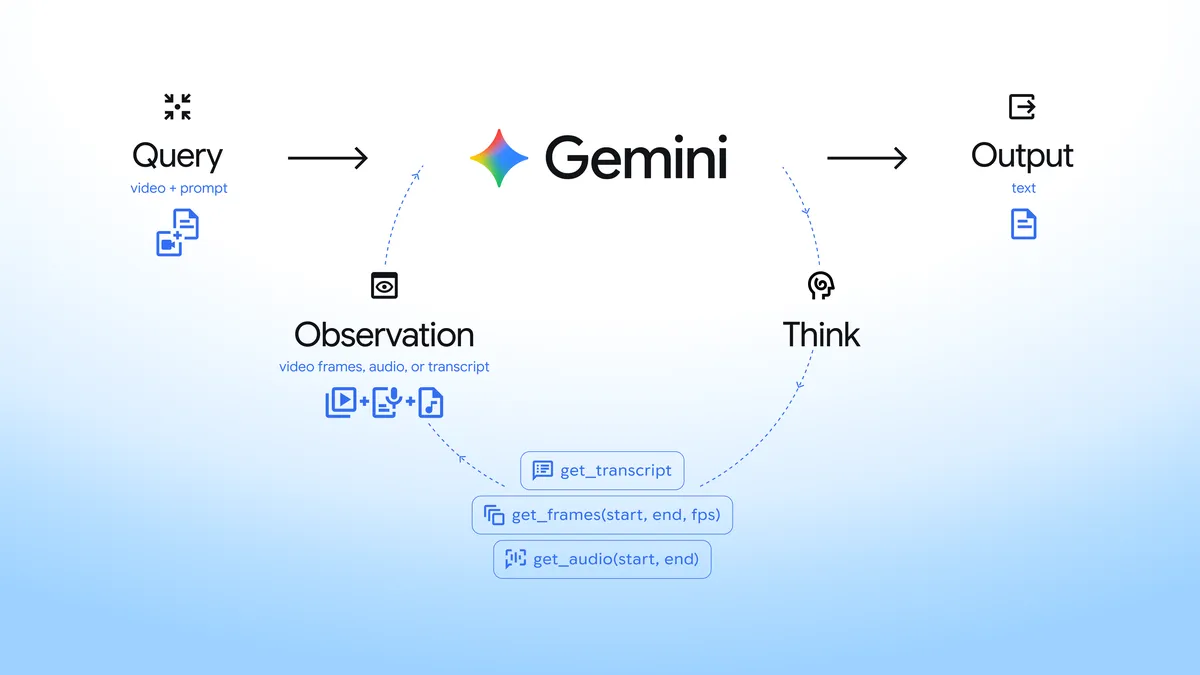
|
| تمثيل بصري يوضح آلية عمل حلقة البحث الذكية والتخطي داخل تقنية agentic video understanding with Gemini |
كيف تعمل حلقة الوكيل (Agentic Loop) من الداخل؟
بدلًا من المعالجة الثابتة التي تستهلك آلاف الإطارات بلا فائدة، يمنح نهج (agentic video understanding with Gemini) النموذج دوراً قيادياً. النظام يعمل الآن كحلقة تفكير (Reasoning Loop): يتلقى طلبك (مثلاً: "متى ظهر الشخص الذي يرتدي قبعة حمراء؟")، ثم يستخدم أدواته الداخلية ليقرر ماذا يشاهد، وبأي سرعة، وعبر أي وسيط (إطارات مرئية، أم مسار صوتي، أم نص مفرغ).
إذا كان المشهد بطيئاً ومملاً، يتخطاه النموذج بسرعة عبر قراءة النص الصوتي. وإذا رصد حركة سريعة ومهمة، يستخدم الأداة المدمجة لإعادة معاينة تلك الثواني المحددة بمعدل إطارات مرتفع جداً (Higher FPS) لالتقاط التفاصيل الدقيقة، تماماً كما يفعل المحقق البشري.
لماذا يهم هذا التحديث؟ (اقتصاديات واجهات برمجة التطبيقات)
عندما راجعت جداول الأداء (Benchmarks) التي نشرتها جوجل، ظننت لوهلة أن هناك خطأ مطبعي في الأرقام؛ خفض الاستهلاك بنسبة 88% ليس مجرد تحديث، بل هو إعادة هيكلة لاقتصاديات الذكاء الاصطناعي بالكامل. التحدي الأكبر في تبني تقنيات الذكاء الاصطناعي للفيديو تجارياً كان التكلفة، وهذا التحديث يضرب هذا الحاجز في مقتل.
وفقاً للبيانات الرسمية من أداة Google AI Studio، أظهرت عائلة (Gemini Flash) المزودة بتقنية الفهم الوكيلي للفيديو نتائج مذهلة على مقاييس الأداء القياسية (مثل LongVideoBench):
- انخفاض استهلاك التوكنز بنسبة تصل إلى 88%.
- خفض التكلفة المادية النهائية للمطورين بنسبة تصل إلى 66%.
- تحسين دقة الاستجابات بنسبة تصل إلى 7%.
📌 نقطة باريتو المثلى (Pareto Frontier) — أكدت الاختبارات أن نموذج (Gemini 3.7 Flash) عند تفعيل ميزة الفهم الوكيلي عليه، يتربع حالياً على أفضل نقطة توازن في العالم بين "الدقة العالية" و"التكلفة المنخفضة" فيما يخص تحليل الفيديو، متفوقاً على كافة النماذج المنافسة في السوق.
هذا الانخفاض يبرز بقوة في مقاطع الفيديو الطويلة الجوهرية، مثل المحاضرات التعليمية التي تصل لـ 90 دقيقة، أو الفيديوهات الإرشادية. في السابق، كان المطور مخيراً بين دفع تكاليف باهظة لتحليل الفيديو بالكامل، أو تقليل جودة الاستخراج وتفويت التفاصيل الدقيقة. وإذا أردت التعمق أكثر في قدرات التفكير الهجين لهذا النموذج بالذات، أنصحك بأن تقرأ الدليل الكامل لـ Gemini 3.7، فهو يشرح كيف يتعامل النموذج مع المنطق المعقد خارج إطار الوسائط المتعددة.
مقارنة فنية: المعالجة الثابتة مقابل تقنية agentic video understanding with Gemini
الفرق بين الطريقتين أشبه بالفرق بين قراءة موسوعة كاملة بحثاً عن كلمة، وبين استخدام الفهرس للوصول للصفحة المطلوبة فوراً. لتوضيح الصورة، دعونا نقارن الآلية القديمة بالآلية الجديدة فنياً.
| الخاصية | المعالجة الثابتة (Static 1 FPS) | الفهم الوكيلي (Agentic Video Understanding) |
| استهلاك التوكنز | مرتفع جداً (يتم تحليل إطار لكل ثانية إجبارياً) | منخفض جداً (-88%) يحلل الإطارات المطلوبة فقط |
| التعامل مع الحركة السريعة | سيء (قد يفوّت أحداثاً تقع في أجزاء من الثانية) | ممتاز (يقوم بإعادة أخذ عينات FPS عالية عند الحاجة) |
| السرعة والأداء | بطيء في الفيديوهات التي تتجاوز الساعة | سريع جداً يعتمد على التوجيه الاستهدافي للبحث |
| التكلفة | باهظة للمقاطع الطويلة | موفرة جداً تصل التخفيضات لـ 66% |
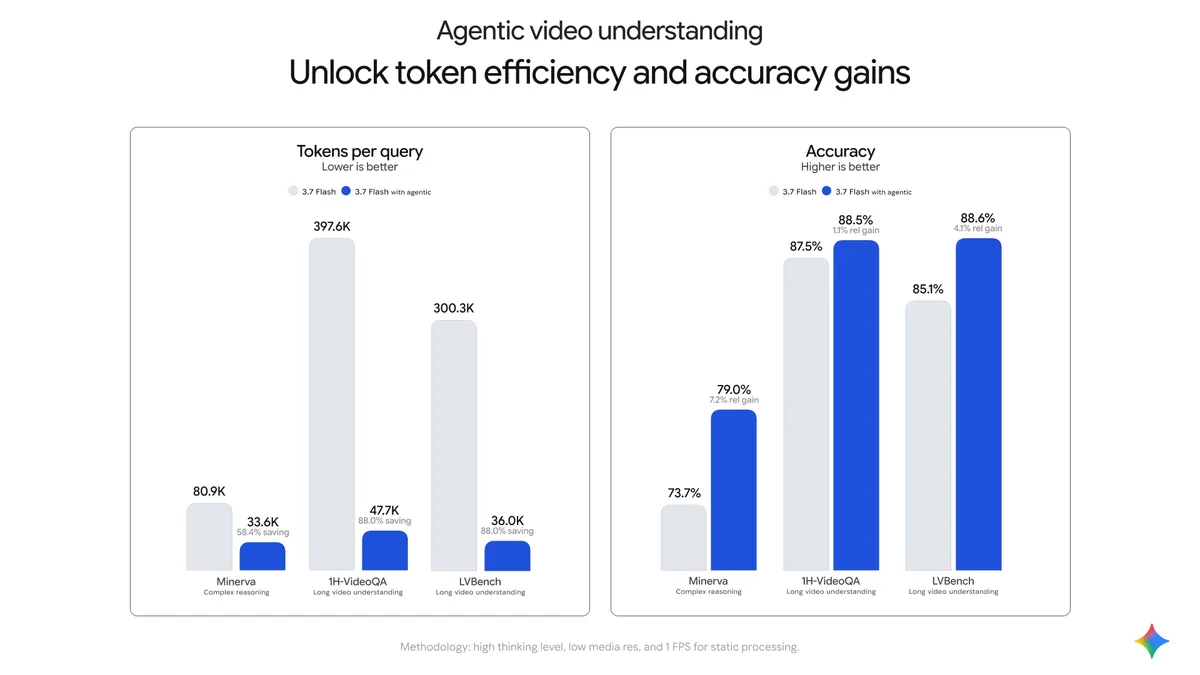
|
| مخطط بياني يوضح انخفاض استهلاك التوكنز بنسبة 88% عند تفعيل ميزة agentic video understanding with Gemini |
حالات استخدام ستغير شكل التطبيقات في العالم العربي
لقد سألني أحد العملاء مؤخراً عن إمكانية أتمتة مراجعة ساعات من لقطات كاميرات المراقبة، ولم أكن أملك حلاً اقتصادياً؛ أما الآن، فالأمر أصبح ممكناً وبأسطر برمجية قليلة. توفر تقنية (agentic video understanding with Gemini) فرصاً هائلة للشركات والمطورين، خاصة في القطاعات التي تعتمد بكثافة على المحتوى المرئي.
1. البحث الدقيق في الفيديوهات الطويلة (Needle-in-a-haystack)
تخيل منصة تعليمية تمتلك مئات الساعات من المحاضرات المسجلة. باستخدام هذه التقنية، يمكن للطلاب طرح سؤال معقد مثل "في أي دقيقة شرح الأستاذ معادلة أينشتاين؟". سيقوم جيميني (Gemini) بتجاوز الساعات غير المهمة وتقديم الإجابة مع التوقيت الدقيق، دون حرق ملايين التوكنز على تحليل صمت الأستاذ أو الفواصل.
2. استرجاع اللحظات بأجزاء الثانية (Sub-second moment retrieval)
في التحليل الرياضي أو صناعة المحتوى، قد تتغير الحالة في أجزاء من الثانية (مثل لحظة ملامسة الكرة لخط المرمى). التحليل الثابت (1 FPS) غالباً ما يفوت هذه اللقطة. الفهم الوكيلي يدرك السياق ويرفع معدل الفحص في تلك الثواني لالتقاط الإطار الحاسم، مما يجعل الأتمتة الدقيقة للمونتاج أمراً واقعياً.
3. اكتشاف الحالات الشاذة (Anomaly detection)
ممتاز جداً لقطاع الأمن والمراقبة. يمكن للنموذج تصفح ساعات من كاميرات المراقبة وتجاهل اللقطات الثابتة، وعندما يرصد حركة أو صوتاً غير مألوف، يعيد فحص "النافذة الزمنية" بدقة عالية لاكتشاف أي سلوك مريب.
4. العد الدقيق للكائنات والحركات
متابعة التمارين الرياضية المتكررة أو تتبع المنتجات على خط تجميع صناعي أصبح أكثر دقة، حيث يراقب النموذج الكائن المطلوب عبر الزمن ويرصد حركته بذكاء.
تجربة برمجية عملية: كيف تفعل الميزة في الكود الخاص بك؟
أجمل ما في هذا التحديث هو بساطة التنفيذ البرمجي. لم أضطر لإعادة كتابة بنيتي التحتية، بل كان الأمر مجرد إضافة مفتاح (Key) واحد في ملف الـ JSON الخاص بالطلب! لتفعيل ميزة (agentic video understanding with Gemini)، كل ما عليك فعله هو إخبار حزمة (Google GenAI SDK) بأنك تريد معالجة وكيلية.
إليك الكود الرسمي بعد التعديل بلغة بايثون (Python):
from google import genai

# تهيئة العميل للاتصال بواجهة برمجة تطبيقات Gemini
client = genai.Client()

# إنشاء تفاعل مع النموذج الأحدث 3.7 Flash
interaction = client.interactions.create(
    model="gemini-3.7-flash",
    input=[
        {
            "type": "video",
            "uri": "gs://your-bucket/your-long-video.mp4",
            "processing": "agentic"  # السر يكمن في هذا السطر!
        },
        {
            "type": "text",
            "text": "استخرج لي أهم 3 إعلانات وردت في هذا المؤتمر بالتوقيت الدقيق.",
        },
    ],
)

# طباعة النتيجة
print(interaction.output_text)
"processing": "agentic". بمجرد تمريره، يتوقف النموذج عن محاولة قراءة الفيديو ككتلة واحدة صماء، ويبدأ في استخدام أدواته الوكيلية للبحث، والتقديم السريع، والتركيز على الصوت. والمفاجأة الأكبر؟ هذه الميزة لا تتطلب أي رسوم إضافية على تسعيرة الواجهة القياسية!
ماذا تفعل الآن؟ (خطة عمل سريعة)
🚀 خطوات عملية:
1. تحديث حزم الـ SDK: تأكد من ترقية مكتبةgoogle-genaiفي بيئة عملك لدعم المعلمات الجديدة للنماذج 3.7 فلاش.
2. إعادة هيكلة مشاريع الفيديو القديمة: إذا كان لديك تطبيقات تقوم بتحليل الفيديوهات وتكلفك الكثير، قم بتعديل الكود فوراً لإضافة معلمة"processing": "agentic"وقارن بين فاتورتي الاستهلاك.
3. استكشاف التحرير الذكي: استفد من هذه الدقة العالية في بناء أدوات للمونتاج التلقائي. وقد خصصنا مقالاً كاملاً لشرح أدوات تحرير الفيديو المتقدمة مع Gemini يستحق الاطلاع عليه לفهم الصورة الكبرى.
الأسئلة الشائعة (FAQ)
هل تقنية Agentic Video Understanding تزيد من وقت الاستجابة (Latency)؟
بشكل عام، لا. لأن النموذج لا يقوم بتحليل كل إطار، بل يقوم بالبحث والتخطي (Seeking)، فإنه غالباً ما يكون أسرع في استخراج الإجابات من الفيديوهات الطويلة جداً مقارنة بالطريقة التقليدية التي تحتاج لمعالجة كل ثانية.
هل تعمل هذه الميزة مع روابط يوتيوب (YouTube) مباشرة؟
نعم، تدعم واجهة Gemini API وتحديداً تقنية الفهم الوكيلي للفيديو تحليل مقاطع يوتيوب مباشرة، بالإضافة إلى الفيديوهات المرفوعة إلى خوادم جوجل كلاود (Google Cloud Storage).
ما هي النماذج الداعمة لهذه التقنية تحديداً؟
الميزة مدعومة حالياً وحصرياً في النماذج: Gemini 3.7 Flash (وهو الأفضل أداءً هنا)، و Gemini 3.6 Flash، والنموذج الخفيف Gemini 3.5 Flash-Lite.
هل هناك تكلفة إضافية لتفعيل خيار "agentic"؟
لا، تعتمد جوجل نفس تسعيرة التوكنز القياسية لواجهة برمجة تطبيقات Gemini دون أي رسوم إضافية لتفعيل هذه الميزة، بل إنها ستخفض فاتورتك النهائية جذرياً.
الخلاصة
إن الانتقال من النماذج اللغوية التي تتلقى البيانات بسلبية إلى نماذج وكيلية (Agentic Models) تبحث عن إجاباتها بنشاط هو التطور الأكثر إثارة في عام 2026. تقنية agentic video understanding with Gemini لا توفر فقط الموارد وتقطع التكاليف بنسبة 66%، بل تمنحنا كمطورين القدرة على بناء تطبيقات تحليل فيديو حقيقية وقابلة للتوسع التجاري، دون الخوف من فواتير الـ API الفلكية. بفضل هذا النهج الوكيلي الديناميكي، أصبح جيميني (Gemini) يقرأ الفيديوهات كما يقرأها البشر؛ يتخطى الملل، ويدقق في التفاصيل المهمة. حان الوقت لتحديث شفراتك البرمجية والبدء في استغلال هذه القوة.